Over dit platform
Wie zegt wat.
Deze site ontleedt Nederlandse politieke debatten op argumenten: wie zegt wat, en waarom. Voor stikstof, abortus, asiel, energietransitie en oekraine zet ze de standpunten van Kamerleden en partijen naast elkaar, met het letterlijke citaat erbij. Zo zie je in één oogopslag welke argumenten er, van welke kant, gebruikt worden. Dat maakt het makkelijk om standpunten te vergelijken tussen partijen, personen en door de tijd heen.
Dit platform dient ook als onderwijsmateriaal: het maakt zichtbaar hoe politieke argumentatie in de praktijk werkt, met echte citaten en hun bron, zodat het bruikbaar is bij het analyseren van politiek debat.
Uitgangspunten
- Geen fact-checking. We registreren welke getallen en claims genoemd worden en door wie, zonder oordeel over of ze kloppen.
- Geen eigen perspectief. Elk argument wordt altijd toegeschreven aan de zender ("volgens X…"), nooit gepresenteerd als objectieve waarheid van de site zelf.
- Redactionele koppeling, geen waarheidscheck. In de argumentenboom (stap 6 hieronder) checkt de redactiestap alleen of een aangedragen weerlegging of onderbouwing aantoonbaar op het andere argument ingaat, niet of een standpunt feitelijk juist is.
- Pro/contra is een classificatie-hulpmiddel. De indeling in pro/contra, toegelicht bovenaan elke topicpagina, ordent het debat, het is geen waardeoordeel over welke kant inhoudelijk gelijk heeft.
Wat is een argument?
Een argument heeft altijd twee delen, en beide moeten letterlijk in het citaat staan: een standpunt (pro/contra/onduidelijk) én een reden of onderbouwing die dat standpunt ondersteunt. Geen onderbouwing betekent geen argument, ook niet als de uitspraak stellig of politiek geladen klinkt.
Eén argument, twee delen
Standpunt
Wat vindt de spreker van de stelling?
Onderbouwing
Wáárom vindt de spreker dat? Een reden, gevolg, voorbeeld of vergelijking.
Dit zijn geen argumenten, met echte citaten uit de database — het aanwezige deel is onderstreept, het ontbrekende deel is de gestippelde streep:
- standpunt
- onderbouwing
- ontbrekend deel
"Ik strijd hier tot de laatste dag om desastreus beleid voor onze boeren en het platteland."
onderbouwing ontbreekt
"De motie op stuk nr. 470 zou ik willen ontraden."
onderbouwing ontbreekt
"Zones rondom Natura 2000-gebieden vinden wij een goed idee; dat is duidelijk."
onderbouwing ontbreekt
"Het flauwe antwoord is dat het bij de Raad van State ligt. En het is geen afkapgrens, om even scherp te zijn; het is een rekengrens."
standpunt ontbreekt
"De antwoorden op de advisering van de Raad van State zullen in het nader rapport, zoals dat heet, worden weerspiegeld."
standpunt ontbreekt
Dit wél, want standpunt én reden staan er allebei, letterlijk in het citaat:
"Met dit pakket nemen we de blokkade weg om vergunningen te verlenen. Alleen met vergunningen kunnen we echt verduurzamen."
"In Nederland kunnen wij zelf keuzes maken over ons eigen lichaam. Dat is een belangrijke verworvenheid."
Ook zuiver procedurele tekst (orde van de vergadering, spreektijd-afspraken, "ik geef het woord aan...") levert nooit een argument op. Een uitspraak over de legitimiteit of spelregels van het debat zelf telt wél mee als argument, mits onderbouwd, zie de typologie "Overig" hieronder.
Wie verder wil lezen: Stanford Encyclopedia of Philosophy over argument en argumentatie voor een algemeen overzicht; Van Eemeren & Grootendorsts pragma-dialectische theorie voor het standpunt-plus-onderbouwing-model zelf; Douglas Waltons argumentatieschema's voor het type redeneerpatroon achter de "Walton"-tags in de taxonomie; en Haddadan, Cabrio & Villata (2019) voor de externe dataset waartegen deze definitie kwantitatief gevalideerd is (zie docs/eval-elecdebate.md).
Hoe de argumenten hier terechtkomen
Bronnen (op dit moment: Tweede Kamer-debatverslagen) worden per sprekerbeurt gesegmenteerd en door een LLM geanalyseerd, dat per beurt 0 of meer argumenten extraheert: een standpunt, een citaat, en eventueel genoemde claims met hun bron. Dit is een geautomatiseerd, foutgevoelig proces, extractiekwaliteit verbetert nog met de tijd, en je kunt op elke kaart feedback geven als iets niet klopt.
1 Crawlen
Debatverslagen worden opgehaald bij de open data van de Tweede Kamer: alle plenaire debatten en commissiedebatten, en aanvullend per onderwerp op trefwoord. Geen LLM, dus dit mag altijd draaien.
2 Segmenteren
Eén verslag (een heel debat) wordt opgeknipt per sprekerbeurt.
3 Beurten aan onderwerpen koppelen
Een beurt hoort bij een onderwerp via de titel van het debat, of doordat de beurt zelf inhoudelijk over het onderwerp gaat. Een beurt kan bij meerdere onderwerpen horen.Hoe dat werkt.
4 Argumenten-extractie
Een lokaal LLM haalt per sprekerbeurt 0 of meer argumenten eruit: standpunt, typologie, citaat, eventuele claims.
5 Tags toekennen
Tags uit de taxonomie hieronder worden toegekend: drie labelgroepen deterministisch, de rest via hetzelfde lokale LLM.
6 Argumentenboom & redactie
Voor elk onderwerp selecteert een LLM een subset van elkaar scherp weersprekende argumenten en legt daar relaties tussen (welk argument onderbouwt of weerlegt welk ander). Elke relatie wordt vervolgens los gecontroleerd: gaat dit argument aantoonbaar in op het andere, of staan ze er alleen toevallig naast? Geen feitelijke-juistheidscheck — alleen of de koppeling zelf standhoudt.
7 Steekproefcontrole
Vóór elke publicatieronde herbeoordelen een mens en Gemini een representatieve steekproef; de resultaten staan in de validatie-rapportage.
8 Export & publicatie
De resultaten worden geëxporteerd en de site wordt daarop statisch gebouwd, zonder server of eigen database.
Hoe een beurt bij een onderwerp komt
Een sprekersbeurt kan op twee manieren bij een onderwerp horen. Via het debat: staat het onderwerp in de titel van het debat, dan horen de beurten daaruit erbij. En via de beurt zelf: ook een beurt in een debat dat over iets anders gaat, zoals een Vragenuur of de Algemene Politieke Beschouwingen, kan inhoudelijk over het onderwerp gaan.
Dat laatste bepalen we met de embeddings van de beurten (zie de plenaire kaart). Per onderwerp berekenen we een profiel uit de beurten die al over dat onderwerp gingen, en een nieuwe beurt wordt gekoppeld als ze dicht genoeg bij dat profiel ligt. Hoe dicht dat moet zijn verschilt per onderwerp en per soort debat. We hebben dat bepaald met steekproeven waarin een lokaal LLM per beurt beoordeelde of ze over het onderwerp gaat. De grens ligt zo dat volgens die beoordeling ongeveer 80% van de gekoppelde beurten echt over het onderwerp gaat.
Een beurt kan bij meerdere onderwerpen horen. Wat gekoppeld is doorloopt daarna dezelfde extractie en tagging als elke andere beurt; een beurt die toch niet over het onderwerp blijkt te gaan, levert daar geen argument op.
De koppeling op inhoud geldt voor debatten vanaf Prinsjesdag 2025 (16 september 2025). Oudere debatten zijn alleen via de titel gekoppeld, dus daar kunnen beurten ontbreken die wel over het onderwerp gaan. De grenzen zijn bepaald op steekproeven van enkele tientallen beurten per onderwerp en op het oordeel van een LLM, dus ongeveer een op de vijf gekoppelde beurten kan er toch naast zitten.
Standpunt & typologie
Elk argument krijgt tijdens de argumenten-extractie een standpunt (de kleur van de kaart) en, om meteen aan te geven wat voor soort onderbouwing erbij hoort, een typologie (het label bovenaan de kaart) mee. Standpunt en typologie zijn onafhankelijk van elkaar: een moreel argument kan net zo goed vóór als tegen zijn. Wat "pro" en "contra" concreet betekenen is per onderwerp gedefinieerd en staat toegelicht bovenaan elke topicpagina.
Standpunt
Onderbouwing (typologie)
Tags beschrijven de vorm van een argument
Naast stance/typologie krijgen argumenten waar mogelijk ook tags uit een argumentatietheoretische taxonomie (o.a. redeneerschema's, en, in de labelgroep "Debatzetten"/"Metadiscussie", retorische patronen zoals herformuleren of persoon aanspreken). Een tag zegt iets over de vorm van een fragment: "dit heeft de vorm van een ad-hominem-constructie." Deze taxonomie-laag is minder uitgebreid gevalideerd dan stance/typologie en kan foutgevoeliger zijn bij subtiele gevallen, zie de validatie-rapportage hieronder voor de laatste steekproefresultaten.
De taxonomie is verdeeld in vier perspectieven, elk met een eigen kleur die overal op de site hetzelfde blijft (correspondentiekaart, tag-grafieken, hieronder). Dit overzicht toont elke tag die op dit moment ergens is toegekend, met beschrijving en het aantal toekenningen over alle onderwerpen heen.
Filosofisch & Argumentatietheoretisch
Communicatie & Media
Politicologisch & Sociaal-Psychologisch
Methodologisch & Contextueel
Hoe favoriete en minst favoriete tags worden bepaald
De personenlijst toont per spreker een favoriet (★) en een minst favoriet (☆) tag. Dit gaat alleen over de tags uit de argumentatietheoretische taxonomie hierboven (LLM-toegekend); afgeleide tags als Arena-Parlement of Actor-Politicus volgen mechanisch uit metadata en zeggen niets over iemands eigen argumentatiestijl, dus die tellen niet mee.
Voor elke tag vergelijken we het aandeel dat een spreker 'm zelf gebruikt (van hun eigen getagde argumenten) met het aandeel over alle sprekers heen. Een ratio boven 1 betekent: deze spreker gebruikt de tag vaker dan gemiddeld; onder 1 betekent minder vaak.
- Favoriet is de tag met de hoogste ratio, met als ondergrens dat de tag in minstens 5% van iemands eigen getagde argumenten voorkomt. Zonder die ondergrens zou een enkele toekenning op een klein volume al een torenhoge (maar betekenisloze) ratio geven.
- Minst favoriet is de tag met de laagste ratio, vaak 0 (nooit gebruikt). Bij een gelijke stand (meerdere tags die iemand nooit gebruikt) telt de tag die over alle sprekers heen het vaakst voorkomt: een tag die verder gangbaar is maar deze spreker nooit gebruikt, is interessanter dan een obscure tag die toch bijna niemand gebruikt.
Bij weinig getagde argumenten is dit minder betrouwbaar; hover over een badge voor de exacte aantallen en de ratio.
Hoe tekststatistieken worden berekend
Elke persoonspagina toont een blokje tekststatistieken: puur tekstuele kenmerken van iemands sprekerbeurten (zinsbouw, woordvariatie, argument- en onderbouwingsdichtheid), los van wat er inhoudelijk gezegd wordt. Dit zijn beschrijvende tekstmetingen, geen oordeel over de kwaliteit van iemands bijdrage.
- Zinsbouw (gem. zinslengte, Flesch-Douma, LIX): standaardmaten uit de leesbaarheidsliteratuur, hier toegepast op gesproken transcripten in plaats van geschreven tekst -- de uitkomst zegt dus iets over zinsbouw en woordlengte, niet over hoe "leesbaar" een gesproken bijdrage was. Lettergrepen worden geteld met een vocaal-groepen-heuristiek (geen volwaardige Nederlandse afbreekregels), dus de exacte score is indicatief.
- Woordvariatie (MSTTR, Mean Segmental Type-Token Ratio): het aandeel unieke woorden, gemiddeld per sprekerbeurt in plaats van over de hele gepoolde tekst -- een kale type-token ratio daalt vanzelf naarmate een tekst langer wordt, MSTTR corrigeert daarvoor.
- Argumentdichtheid (argumenten per 1000 tekens): hoeveel geëxtraheerde argumenten (zie hierboven) een spreker haalt uit een gegeven hoeveelheid gesproken tekst.
- Onderbouwing (claims per argument): hoe vaak een argument vergezeld gaat van een concreet genoemd cijfer, feit of bron (zie claims verderop).
Elke maat toont ook de mediaan over alle sprekers met minstens 3 sprekerbeurten, als ijkpunt voor een "typische" spreker. Bij deze dichtheidsmaten ligt de verdeling scheef -- een enkele spreker met veel argumenten per 1000 tekens trekt een gemiddelde flink omhoog, de mediaan is dan representatiever dan een gemiddelde. De richtingaanduiding (bv. "hoger = complexer") is puur beschrijvend: een hogere of lagere waarde is geen betere of slechtere bijdrage, alleen een ander soort formulering.
Wat betekent de tik boven een balk in het tag-overzicht?
De taghistogram op elke persoons- en partijpagina toont per tag in hoeveel procent van de getagde argumenten van deze persoon of partij 'm gebruikt wordt (bv. "16%", oftewel 79 van de 490 getagde argumenten). Getagde argumenten, niet alle argumenten: bijna de helft van alle argumenten krijgt geen enkele LLM-tag (bv. te kort, of buiten de taxonomie), en die als nul meetellen zou elk percentage verdunnen. Percentage i.p.v. een kaal aantal, want anders is een balk niet vergelijkbaar tussen bv. een minister met honderden argumenten en een achterbanker met een handvol -- beiden kunnen ruwweg even vaak per argument een tag gebruiken, ook al ligt hun kale telling mijlenver uit elkaar.
De verticale tik bovenop een balk is de mediaan van datzelfde percentage: hoe vaak een typische spreker (op de persoonspagina) of typische partij (op de partijpagina) diezelfde tag gebruikt, ook uitgedrukt als percentage van hun eigen argumenten. Ligt de balk voorbij de tik, dan gebruikt deze persoon/partij die tag bovengemiddeld vaak; blijft de balk erbinnen, dan is het ondergemiddeld.
Op een persoonspagina staat er, als de spreker een partij heeft, ook een klein partijicoontje bij: diezelfde mediaan, maar dan alleen berekend over de fractiegenoten van deze spreker in plaats van de hele Kamer. Zo zie je niet alleen of iemand landelijk op- of ondergemiddeld scoort op een tag, maar ook of dat binnen de eigen fractie al opvalt.
Wat is een correspondentiekaart?
Elke topicpagina toont een correspondentiekaart: partijen (of personen) en tags samen in één plaatje. Punten die dicht bij elkaar staan, horen bij elkaar: twee partijen dicht bij elkaar gebruiken vergelijkbare soorten argumenten, twee tags dicht bij elkaar worden vaak samen toegekend. Een tag dicht bij een partij betekent dat die partij die tag relatief vaak gebruikt, niet per se vaker dan andere partijen in absolute aantallen, maar relatief tot haar eigen totaal.
De kaart is interactief: klik op een punt om erop te filteren, of wissel bovenaan de kaart tussen partijen en personen als rijen. Ze draait volledig in de browser (de techniek heet correspondentieanalyse, afgekort CA), zodat ze live meebeweegt met het filter bovenaan de pagina.
Hoe de kaart tot stand komt
We beginnen met een voorbeeld: een echte uitsnede uit de huidige data (drie partijen, drie tags, de volledige kaart gebruikt alle partijen/personen en alle toegekende tags tegelijk). Deze drie tags:
| Partij | Ideologie-GAL | Ideologie-TAN | Moraliteit-Autoriteit | Rijtotaal |
|---|---|---|---|---|
| BBB | 7 | 146 | 87 | 240 |
| D66 | 166 | 0 | 42 | 208 |
| SGP | 1 | 85 | 19 | 105 |
| Tagtotaal | 174 | 231 | 148 | 553 |
D66 gebruikt Ideologie-GAL in 166 van de 208 toekenningen (80%) en Ideologie-TAN vrijwel nooit. BBB en SGP zijn het spiegelbeeld: samen goed voor 231 van de 231 Ideologie-TAN-toekenningen en nauwelijks Ideologie-GAL. Moraliteit-Autoriteit wijst niet zomaar naar dezelfde plek als Ideologie-TAN: BBB gebruikt die tag relatief vaker (87 van de 240, 36%) dan SGP (19 van de 105, 18%), een nuance die in een kale TAN/GAL-indeling verloren zou gaan.
Correspondentieanalyse (CA) zet dat soort verschil om in een positie op de kaart. Toegepast op precies deze tabel (zonder de weergave-compressie uit de laatste stap hieronder, bij drie rijen en drie tags is er nog niets te comprimeren):
Ruit = tag, cirkel = partij. Resultaat: D66 komt ver van BBB en SGP te liggen, dicht bij Ideologie-GAL; BBB en SGP clusteren aan de Ideologie-TAN-kant, met BBB net iets dichter bij Moraliteit-Autoriteit dan SGP.
Dat gebeurt in zes stappen:
1 Tellen
Voor elke combinatie van rij (partij of persoon) en tag: hoeveel argumenten hebben die combinatie? Dat leverde de tabel hierboven op. Alleen LLM-toegekende tags tellen mee, de drie deterministisch afgeleide labelgroepen staan bij vrijwel elk argument en zouden geen signaal toevoegen. Rijen en tags met te weinig toekenningen vallen weg; onder drie rijen of drie tags stopt de analyse (te weinig voor een zinnige uitspraak).
2 Afwijking van "geen verband"
Elke cel wordt vergeleken met wat je zou verwachten als rij en tag niets met elkaar te maken hadden (rijgrootte × tagpopulariteit). Wat overblijft is een tabel met residuen: hoe sterk, en in welke richting, wijkt elke combinatie af van dat neutrale nulpunt.
3 Assen zoeken (SVD)
Een singuliere-waardenontbinding vindt de assen waarlangs die afwijkingen het sterkst uiteenlopen. De eerste assen vangen het meeste patroon: hun aandeel staat als percentage (verklaarde inertie) bij elke as op de kaart.
4 Coördinaten
Rijen én tags krijgen allebei een positie op diezelfde assen. Daardoor is de afstand tussen twee rijen onderling, en tussen twee tags onderling, interpreteerbaar, maar de afstand van een rij tot een tag alleen richtinggewijs, niet als letterlijke maat.
5 Tekenconventie
De ontbinding uit stap 3 legt geen teken vast: een as mag zonder betekenisverschil spiegelen. Zonder correctie zou de kaart dus willekeurig links-rechts of boven-onder omklappen zodra er nieuwe data bijkomt. Een vaste oriëntatieregel voorkomt dat.
6 Weergave-compressie
Eén zeldzame tag kan een afstand tot de kern hebben die de rest van de puntenwolk tot een vlekje samenperst. Vlak vóór het tekenen worden dat soort uitschieters radiaal naar de kern getrokken (richting blijft gelijk). Dit is puur een weergavetruc, ná de echte analyse: afstanden op de kaart zijn daardoor geen letterlijke chi-kwadraatafstanden meer, alleen richting en relatieve volgorde blijven behouden.
Wat is de plenaire kaart?
De overzichtspagina van alle onderwerpen toont een interactieve plenaire kaart. Hierin is elke sprekersbeurt uit de plenaire vergaderingen van de Tweede Kamer afgebeeld als één punt. Punten die dicht bij elkaar liggen, behandelen inhoudelijk vergelijkbare onderwerpen; punten die ver van elkaar liggen, gaan over heel andere thema's.
De kaart stelt je in staat om te zien hoe de vier uitgelichte onderwerpen (stikstof, abortus, asiel en energietransitie) zich verhouden tot het bredere parlementaire werk — van justitie en defensie tot zorg en buitenlandse zaken.
Begrippen op de kaart
Onderwerp is een van de uitgewerkte onderwerpen waar we argumenten uit halen, taggen en in een argumentenboom zetten.
Gebied is een cluster op de kaart: een groep spreekbeurten die inhoudelijk dicht bij elkaar ligt. Een hoofdgebied is een groot gebied op het hoogste niveau, een deelgebied ligt daarbinnen. Een gebied is niet hetzelfde als een onderwerp: veel gebieden horen bij geen enkel uitgewerkt onderwerp, en een onderwerp kan meerdere gebieden beslaan.
Witte vlek is een gebied waar een partij veel minder spreekbeurten heeft dan op grond van het aandeel van die partij in alle debatten te verwachten was. Een zwaartepunt is het omgekeerde: een gebied waar een partij veel meer spreekbeurten heeft dan verwacht. Het verwachte aantal is per kamerperiode berekend, zonder de beurten van bewindspersonen. Gebieden die vooral debatprocedure zijn, zoals het verlenen van het woord of het indienen van moties, tellen niet mee: elke fractie spreekt in elk debat procedureel, dus dat zegt niets over een onderwerp.
Beide zeggen alleen iets over wat er in de plenaire debatten en commissiedebatten is gezegd. Ze zeggen niets over motieven, over moties, schriftelijke vragen of stemgedrag, en niets over de taakverdeling binnen een fractie.
Hoe de plenaire kaart tot stand komt
1 Tekst-embeddings (BGE-M3)
Elke sprekersbeurt uit de officiële Handelingen wordt omgezet in een hoogdimensionale betekenisvector (embedding). Woorden en zinsneden met een vergelijkbare betekenis komen dicht bij elkaar in deze vectorruimte te liggen.
2 Dimensiereductie (UMAP)
Het UMAP-algoritme projecteert de tienduizenden vectoren naar een tweedimensionaal vlak. UMAP behoudt daarbij de lokale topologische structuur: spreekbeurten over hetzelfde wetsvoorstel of beleidsterrein blijven in elkaars nabijheid.
3 Hiërarchische clustering (HDBSCAN condensed tree)
In plaats van een vaste clusterdrempel loopt het algoritme de vertakkingsboom (condensed tree) van HDBSCAN top-down af, op vijf aflopende drempels: van een handvol brede beleidsdomeinen tot honderden smalle deelthema's. Elk niveau is een snede van dezelfde boom, dus een deelthema valt altijd binnen precies één beleidsdomein.
4 Voorstel voor naam & duiding (taalmodel + kenmerkende woorden)
Per cluster worden de kenmerkende woorden berekend: welke woorden maken deze spreekbeurten anders dan de rest van de kaart. Dat gebeurt exact, uit de woordgewichten (sparse vectoren) die BGE-M3 naast de gewone embedding geeft, met uitsluiting van procedurele Kamertermen. Een lokaal taalmodel (Qwen) doet op basis van die woorden, de spreekbeurten die het dichtst bij het clustermiddelpunt liggen en de naam van het bovenliggende beleidsdomein een voorstel voor een themanaam en een korte duiding. Het blijft een voorstel: het model mag de naam van de ouder niet herhalen en geen vage woorden gebruiken.
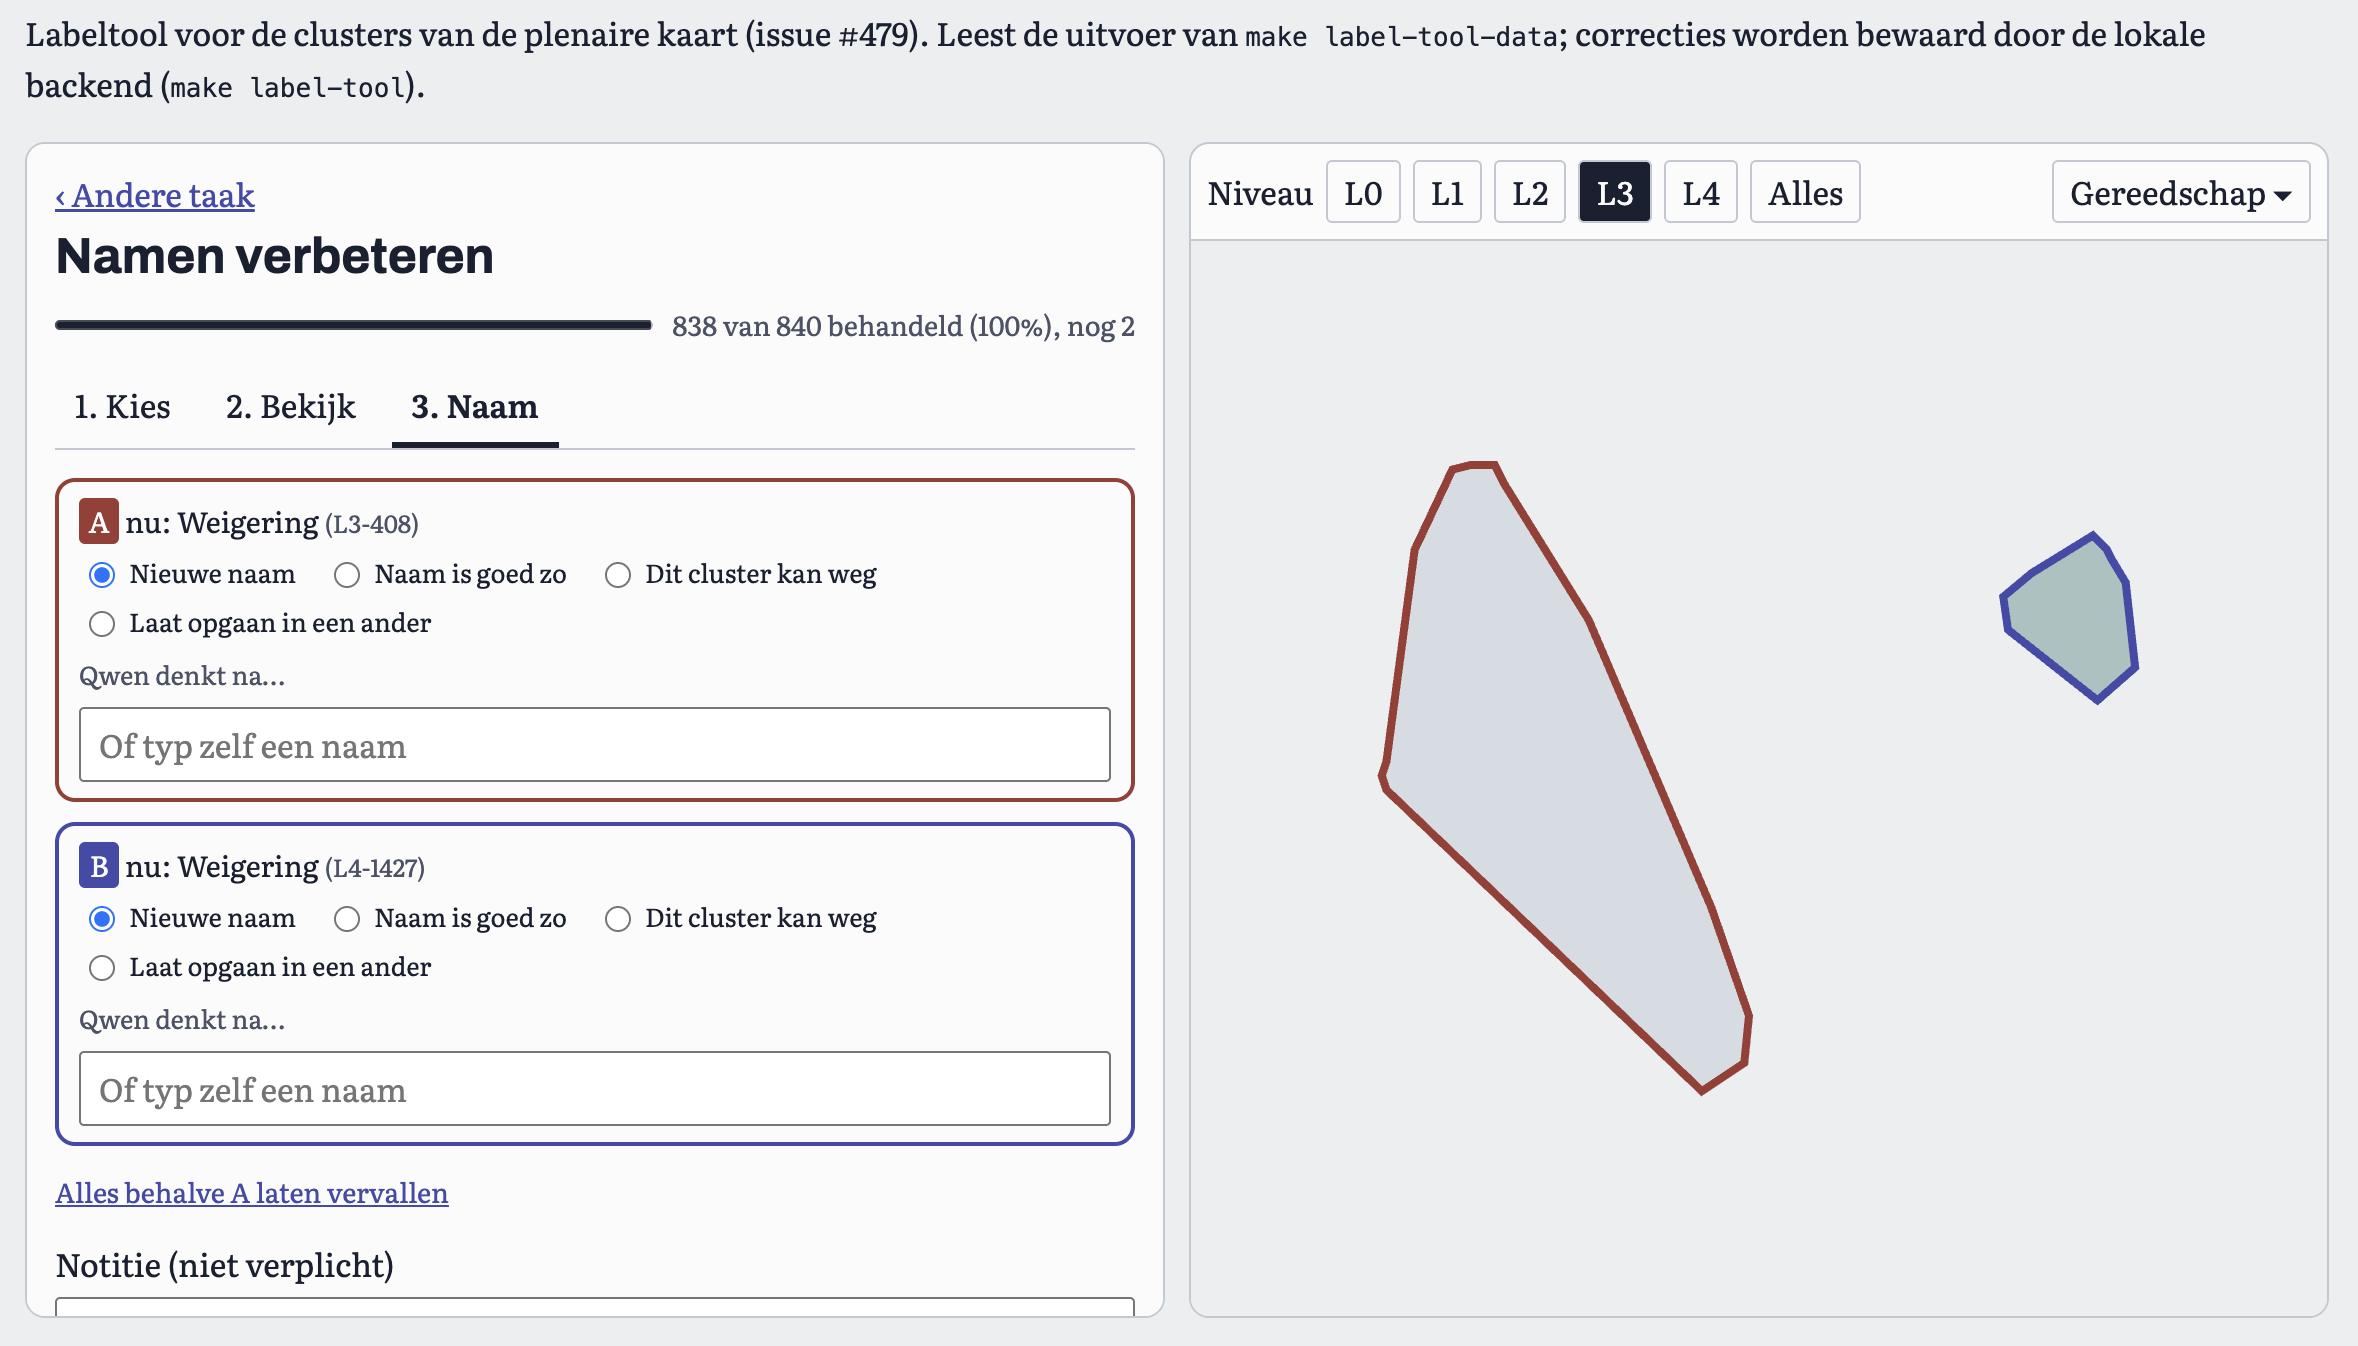
5 Handmatig labelen in de labeltool
Clusters krijgen zelden in één keer een goed label, dus elk cluster wordt door een redacteur beoordeeld in een eigen labeltool, nooit automatisch in bulk. Daar corrigeer je de structuur (clusters die op elkaar lijken bundelen, een cluster met meerdere onderwerpen opnieuw verdelen), verbeter je de namen en teken je zo nodig gebieden op de kaart. Een naam is kort, bevat geen vage woorden (zoals beleid of procedure), geen personen of partijen en herhaalt de ouder niet. Elke correctie wordt met reden vastgelegd; bijna duizend zijn zo gemaakt. De kenmerkende woorden en voorbeeldfragmenten staan daarbij in beeld, zodat elke naam te controleren is.
6 Renderen als vector tiles (MapLibre + deck.gl)
Alle sprekersbeurten uit acht jaar plenaire debatten worden als vector tiles (PMTiles) geserveerd en in de browser getekend met MapLibre GL en deck.gl — dezelfde schaalbare tegeltechniek als een gewone kaartviewer, met dichtheidsbewuste puntreductie per zoomniveau zodat uit- en inzoomen vloeiend blijft.
Waarom BGE-M3?
We hebben BGE-M3 vergeleken met twee andere embeddingmodellen: Qwen3-Embedding-8B en E5-NL, een Nederlandstalig model van de Universiteit Antwerpen. Alle drie zijn losgelaten op dezelfde 9.950 sprekersbeurten uit november 2025 tot en met juli 2026.
Voor elke beurt hebben we de tien beurten genomen die het model er het dichtst bij legt, en gekeken welk deel daarvan een label deelt met de beurt zelf. Die labels komen van de Tweede Kamer en hangen dus niet van een model af:
- Zelfde debattitel. De titel die de Tweede Kamer aan het debat geeft. Het is gemiddeld per titel, zodat grote debatten niet domineren.
- Zelfde dossier, ander debat. Hier tellen buren uit hetzelfde debat niet mee. Een buur telt als het debat waaruit die komt een wetsdossier deelt met het debat van de beurt. Dit toetst of een model verwante beurten bij elkaar zet, ook als ze in een ander debat zijn gezegd. Het is gemeten op de 2.504 beurten waarvoor zo'n verwant debat in de steekproef zit.
| Model | Zelfde debattitel | Zelfde dossier, ander debat |
|---|---|---|
| BGE-M3 | 27,3% | 13,2% |
| Qwen3-Embedding-8B | 23,9% | 11,2% |
| E5-NL | 20,1% | 9,5% |
| Willekeurig gekozen beurten | 0,9% | 1,2% |
Een percentage is het gemiddelde aandeel van de tien buren dat het label deelt. Het is geen aandeel correcte antwoorden: een buur met een andere titel kan inhoudelijk wel verwant zijn, dus de percentages zijn alleen zinvol naast elkaar en naast de kans bij willekeurige beurten.
BGE-M3 scoort op beide maatstaven het hoogst. Alle drie de modellen liggen ver boven wat toeval zou geven. Qwen3-Embedding-8B is gedraaid als 4-bit-versie via LM Studio, dus een volledige versie kan anders scoren. E5-NL leest maximaal 512 tokens, dus langere beurten zijn in stukken gedeeld en de vectoren zijn daarna gemiddeld. Het is een vergelijking op deze twee maatstaven en deze steekproef, geen volledige beoordeling van elk model.
Transparantie & reproduceerbaarheid
We claimen geen feilloosheid, wel traceerbaarheid: elk argument is te herleiden tot het exacte model, de exacte promptversie en de brontekst waaruit het is gedestilleerd.
- Databronnen. De debatverslagen komen van de Open Data van de Tweede Kamer (OData-API, VLOS-XML van elke Vergadering/Verslag) — bij elk argument staat een link naar zowel deze ruwe brondata als naar de bijbehorende officiële tweedekamer.nl-pagina van het debat. Video's linken naar Debat Direct, de officiële videowebsite van de Tweede Kamer.
- Modellen & promptversies. Argumenten-extractie, tagging en de steekproefbeoordelingen voor de onderwerp-koppeling draaien lokaal via een open-source model (momenteel
qwen/qwen3.8-27b); het bouwen van de argumentenboom (stap 6) gebruikt Gemini, vanwege het grotere contextvenster dat nodig is om de volledige argumentenset van een onderwerp in één keer te doorzoeken. Validatiesteekproeven gebruiken daarnaast Gemini als tweede beoordelaar. Van elk argument wordt bijgehouden met welke promptversie het gemaakt is, zodat een prompt- of modelwijziging altijd traceerbaar is. - Energieverbruik & CO2 (ruwe schatting). Over de volledige geschiedenis van extractie- en tag-calls (ca. 63.755 LLM-aanroepen) schatten we het energieverbruik op ca. 49 kWh (ca. 15,2 kWh lokaal, ca. 33,5 kWh op afstand) en de uitstoot op ca. 5,4 kg CO2. Dit is een grove indicatie, geen meting: gebaseerd op een gepubliceerde vuistregel van ~0,3 Wh per 1000 tokens voor een vergelijkbaar (grotere) model, toegepast op het totaal aantal prompt- + completion-tokens uit onze eigen logging. De lokale calls (via LM Studio) draaien op groene stroom en tellen hier daarom als CO2-vrij mee; de uitstoot (ca. 5,4 kg) komt dus volledig van de 69% van de tokens die op afstand verwerkt zijn (OVHcloud via de Hugging Face-router), gerekend met OVHclouds eigen 2024-cijfer van 0,16 kg CO2 per kWh. De redactie-stap (het bouwen van de argumentenboom, via Gemini) logt geen tokens en zit dus niet in dit cijfer — in verhouding tot het totaal aantal extractie-/tag-calls is dat een klein deel van het werk.
- Validatie-rapportage. Vóór elke publicatieronde wordt een representatieve steekproef per onderwerp handmatig + door een tweede LLM herbeoordeeld. Zie de validatie-rapportage voor de laatste resultaten (foutpercentage en systematische patronen per stage).
- Open werkwijze. De volledige pipeline, prompts en taxonomie staan in de broncode van dit platform, niet alleen in deze uitleg. Zie de broncode op GitHub.